 Code0
“变笨”到底发生在哪里
先看模型版本。OpenAI 官方公开资料把 GPT-5.6 描述为一个模型家族,并提供 Sol、Terra、Luna 等不同定位,强调默认效率和按需提升能力。企业如果把模型别名直接写死在业务代码里,或依赖供应商自动迁移,模型升级后输出风格、工具调用和推理深度都可能变化。生产系统应记录实际模型 ID、版本、请求参数和路由结果,不能只记录“调用了 GPT-5.6”。
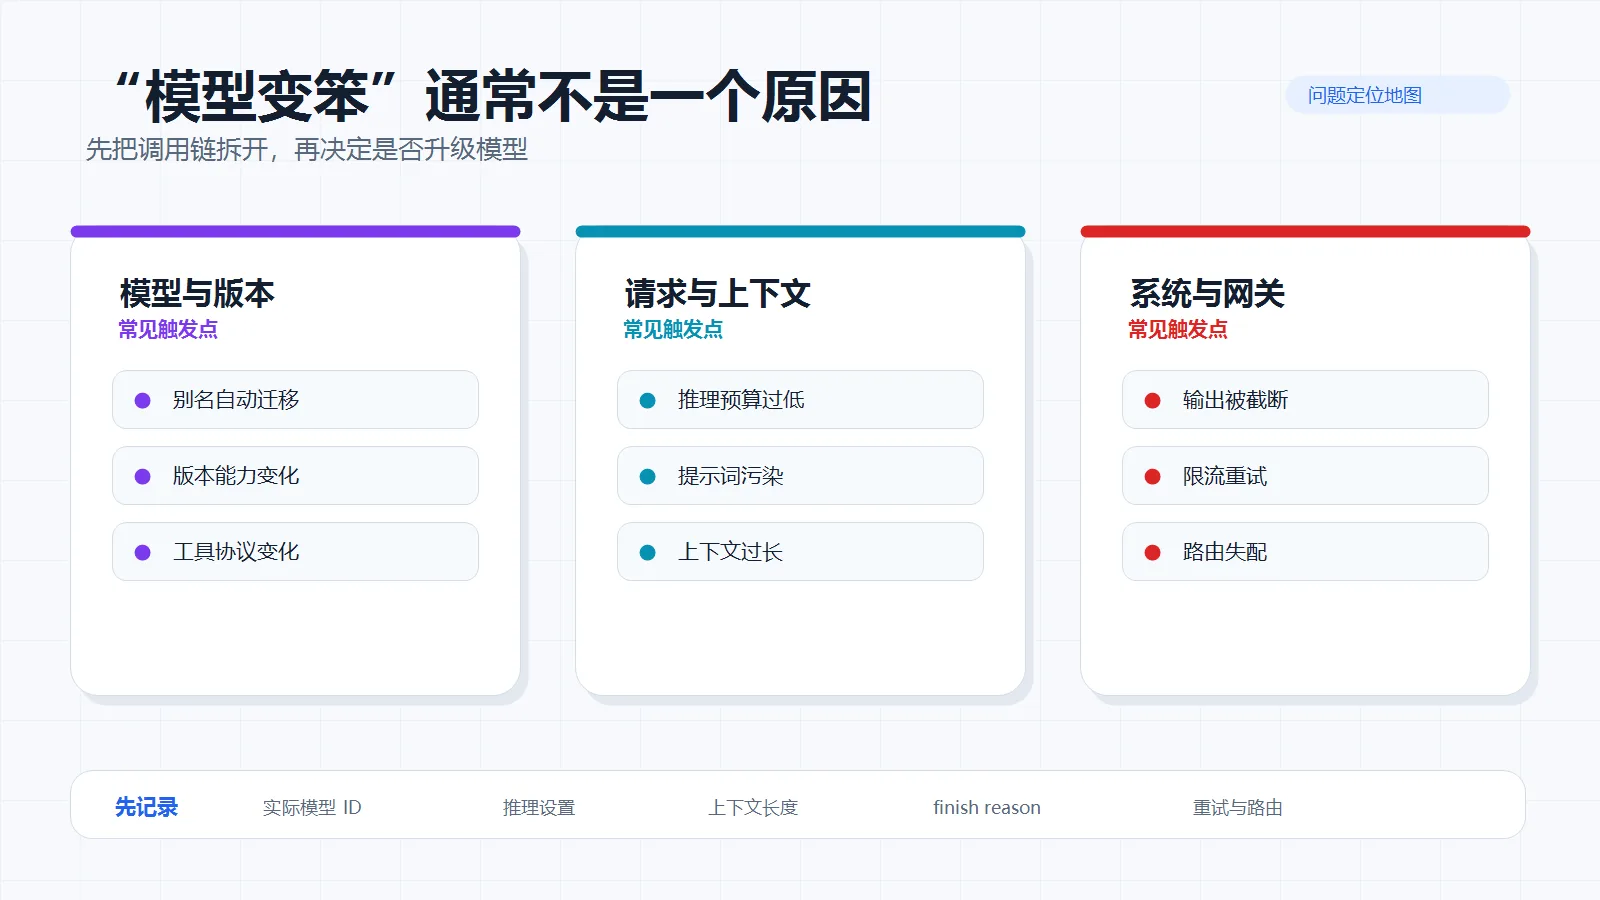
再看推理设置。复杂问题要求模型拆解任务、检查假设、调用工具,低难度问答却不需要同样的思考成本。如果统一把 reasoning effort、最大输出 Token 或超时阈值设得很低,模型就容易显得敷衍;设置过高,又会增加延迟和 API 账单。更合理的做法是按任务难度分档,简单分类走轻量配置,代码修复、研究分析和多步 Agent 使用更高档位。
上下文也是常见嫌疑。历史对话太长、系统提示词重复、检索文档互相矛盾,都会稀释当前任务。企业知识库要做分块、重排、权限过滤和引用校验;多轮会话要定期压缩摘要,清理已完成的工具结果。
先改调用策略,再判断模型能力
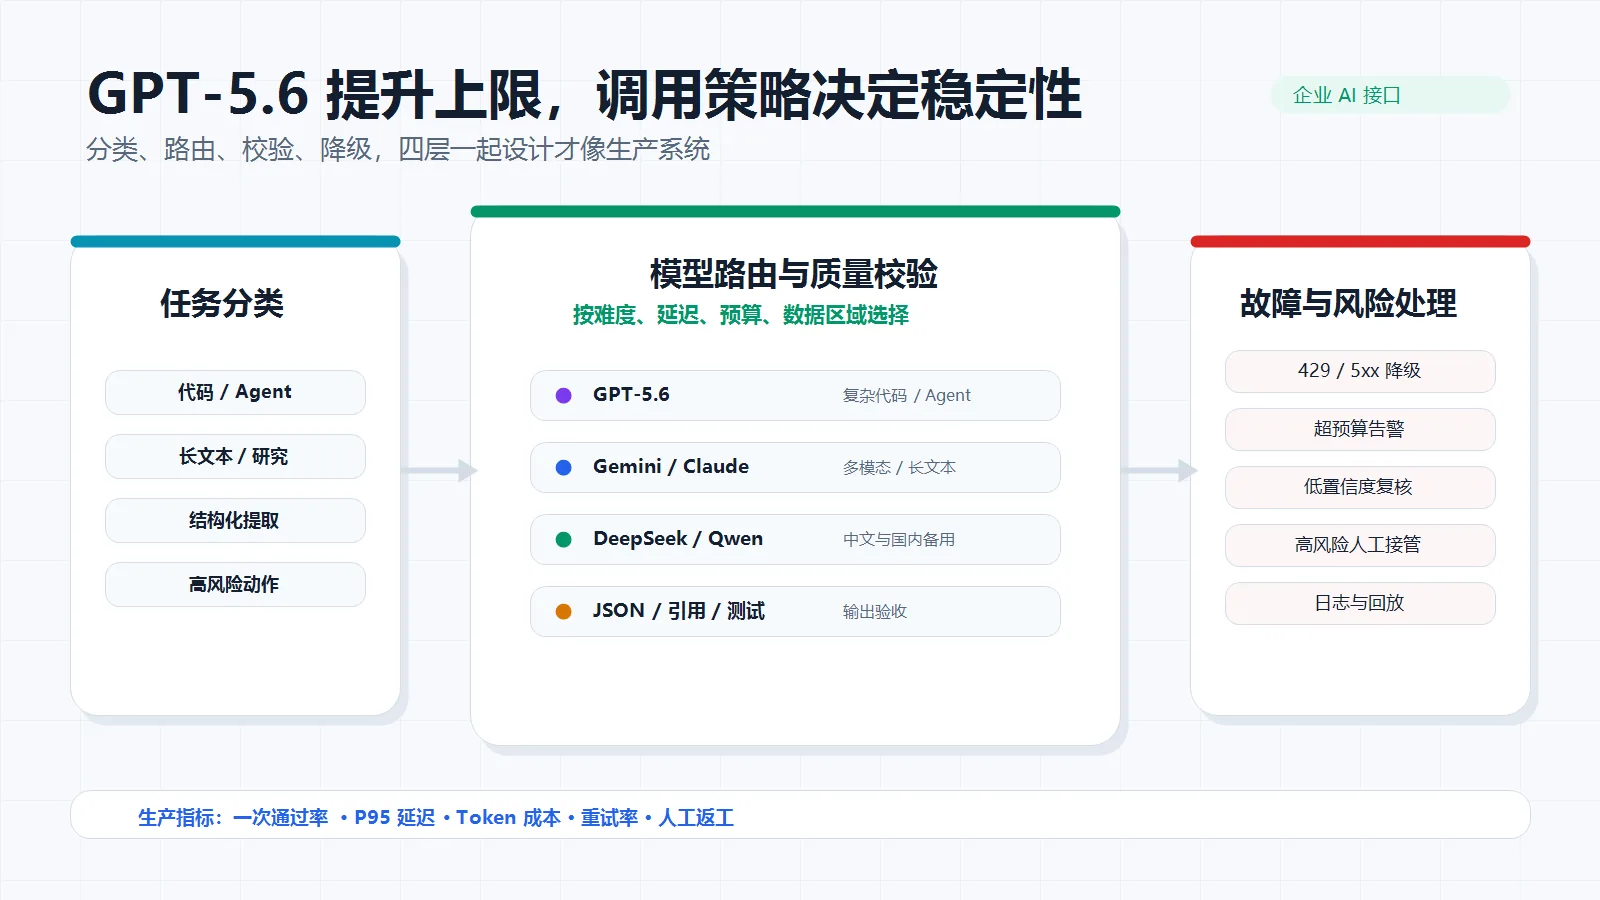
很多团队遇到质量下降,会直接更换模型,却不检查请求链路。可以把调用分成四层:任务分类、模型路由、质量校验、失败处理。任务分类识别代码、长文本、结构化提取、客服问答和高风险动作;模型路由根据难度、延迟、预算、数据区域选择候选;质量校验检查 JSON、引用、字段完整度和代码测试;失败处理负责重试、降级和人工接管。
提示词也要从“请认真回答”改成可验证的任务契约。明确输入边界、输出格式、禁止臆测的条件、完成标准和遇到信息不足时的动作。代码任务应要求列出修改文件、说明假设、运行测试并报告未完成项;知识库问答应要求引用证据,找不到依据时返回待核验状态。这样做比反复添加“不要偷懒”更有效。
GPT-5.6 适合解决哪些问题
GPT-5.6 更适合需要较强推理、代码开发、知识工作、研究分析和复杂 Agent 的任务。GPT-5.6 API 可以作为复杂请求的主模型候选,尤其适合代码审查、跨文件修改、长流程规划、复杂资料归纳和需要多轮工具协作的产品。具体可用模型、接口能力、价格和地区限制应以 OpenAI 官方最新文档与控制台为准。
它也可能帮助解决“模型偷懒”,但前提是调用端给了足够的推理空间,任务上下文干净,工具权限正确,结果有验收机制。一个更强的模型遇到模糊指令、失效工具或过低输出上限,照样会给出不完整答案。
哪些场景不能只靠升级模型
高风险审批、金融判断、医疗建议、法律结论和自动执行付款,不能把模型升级当作风险控制。模型可以整理材料、生成候选方案、标注缺失信息,最终结论仍应经过规则、权限和人工确认。
高频客服、批量摘要、标签提取和简单改写,也不一定适合全量使用 GPT-5.6。若任务可校验、价值单次较低,轻量模型更容易控制成本和延迟。OpenAI API、Claude API、Gemini API 可以分别作为复杂代码、长文本、多模态和跨语言任务的候选;DeepSeek API、Qwen API、GLM API、Kimi API、MiniMax 等国内大模型 API 可用于中文高频请求和境内备用。
多模型接入怎样避免“越兜底越混乱”
多模型不是随机切换。企业要建立任务路由表,固定每类任务的主模型、备用模型、升级条件和降级条件。比如 GPT-5.6 负责复杂代码和 Agent,Gemini API 处理多模态或跨语言,国内模型承接中文批处理;出现 429、5xx、延迟超标、预算超限或结构化失败,再切换备用链路。
不同供应商的消息格式、工具调用、流式事件、错误码和安全策略并不一致。直接在业务代码里堆很多 SDK,后续很难排查“究竟是模型变了,还是适配层坏了”。AI API 聚合平台可以通过统一的企业 AI 接口管理鉴权、额度、预算、日志、模型路由和故障切换。像 Code0 这类平台适合把 GPT-5.6、OpenAI API、Claude API、Gemini API 和国内大模型 API 放进同一调用层,方便做多模型接入与 API 成本优化。
一套实用的排查顺序
拿同一批脱敏样本做版本对照,固定提示词、工具和参数,记录模型 ID、推理设置、上下文长度、首 Token 延迟、完整耗时、一次通过率、重试率和人工返工时间。再分别测试短问答、长文本、代码、JSON、工具调用和异常输入。若基础样本正常,线上变差,重点查路由、上下文、限流和网关;若固定样本也退化,再考虑模型版本、提示词或评测集变化。
GPT-5.6 可以提升上限,却不能替代调用治理。企业想解决“模型变笨”,应把模型升级、参数分档、上下文整理、输出验收和多模型兜底一起设计。模型负责能力,策略负责把能力稳定地变成业务结果。